- 프론프트 Fronmpt
- Posts
- 짜장이냐 짬뽕이냐, 선택만 하는 AI
짜장이냐 짬뽕이냐, 선택만 하는 AI
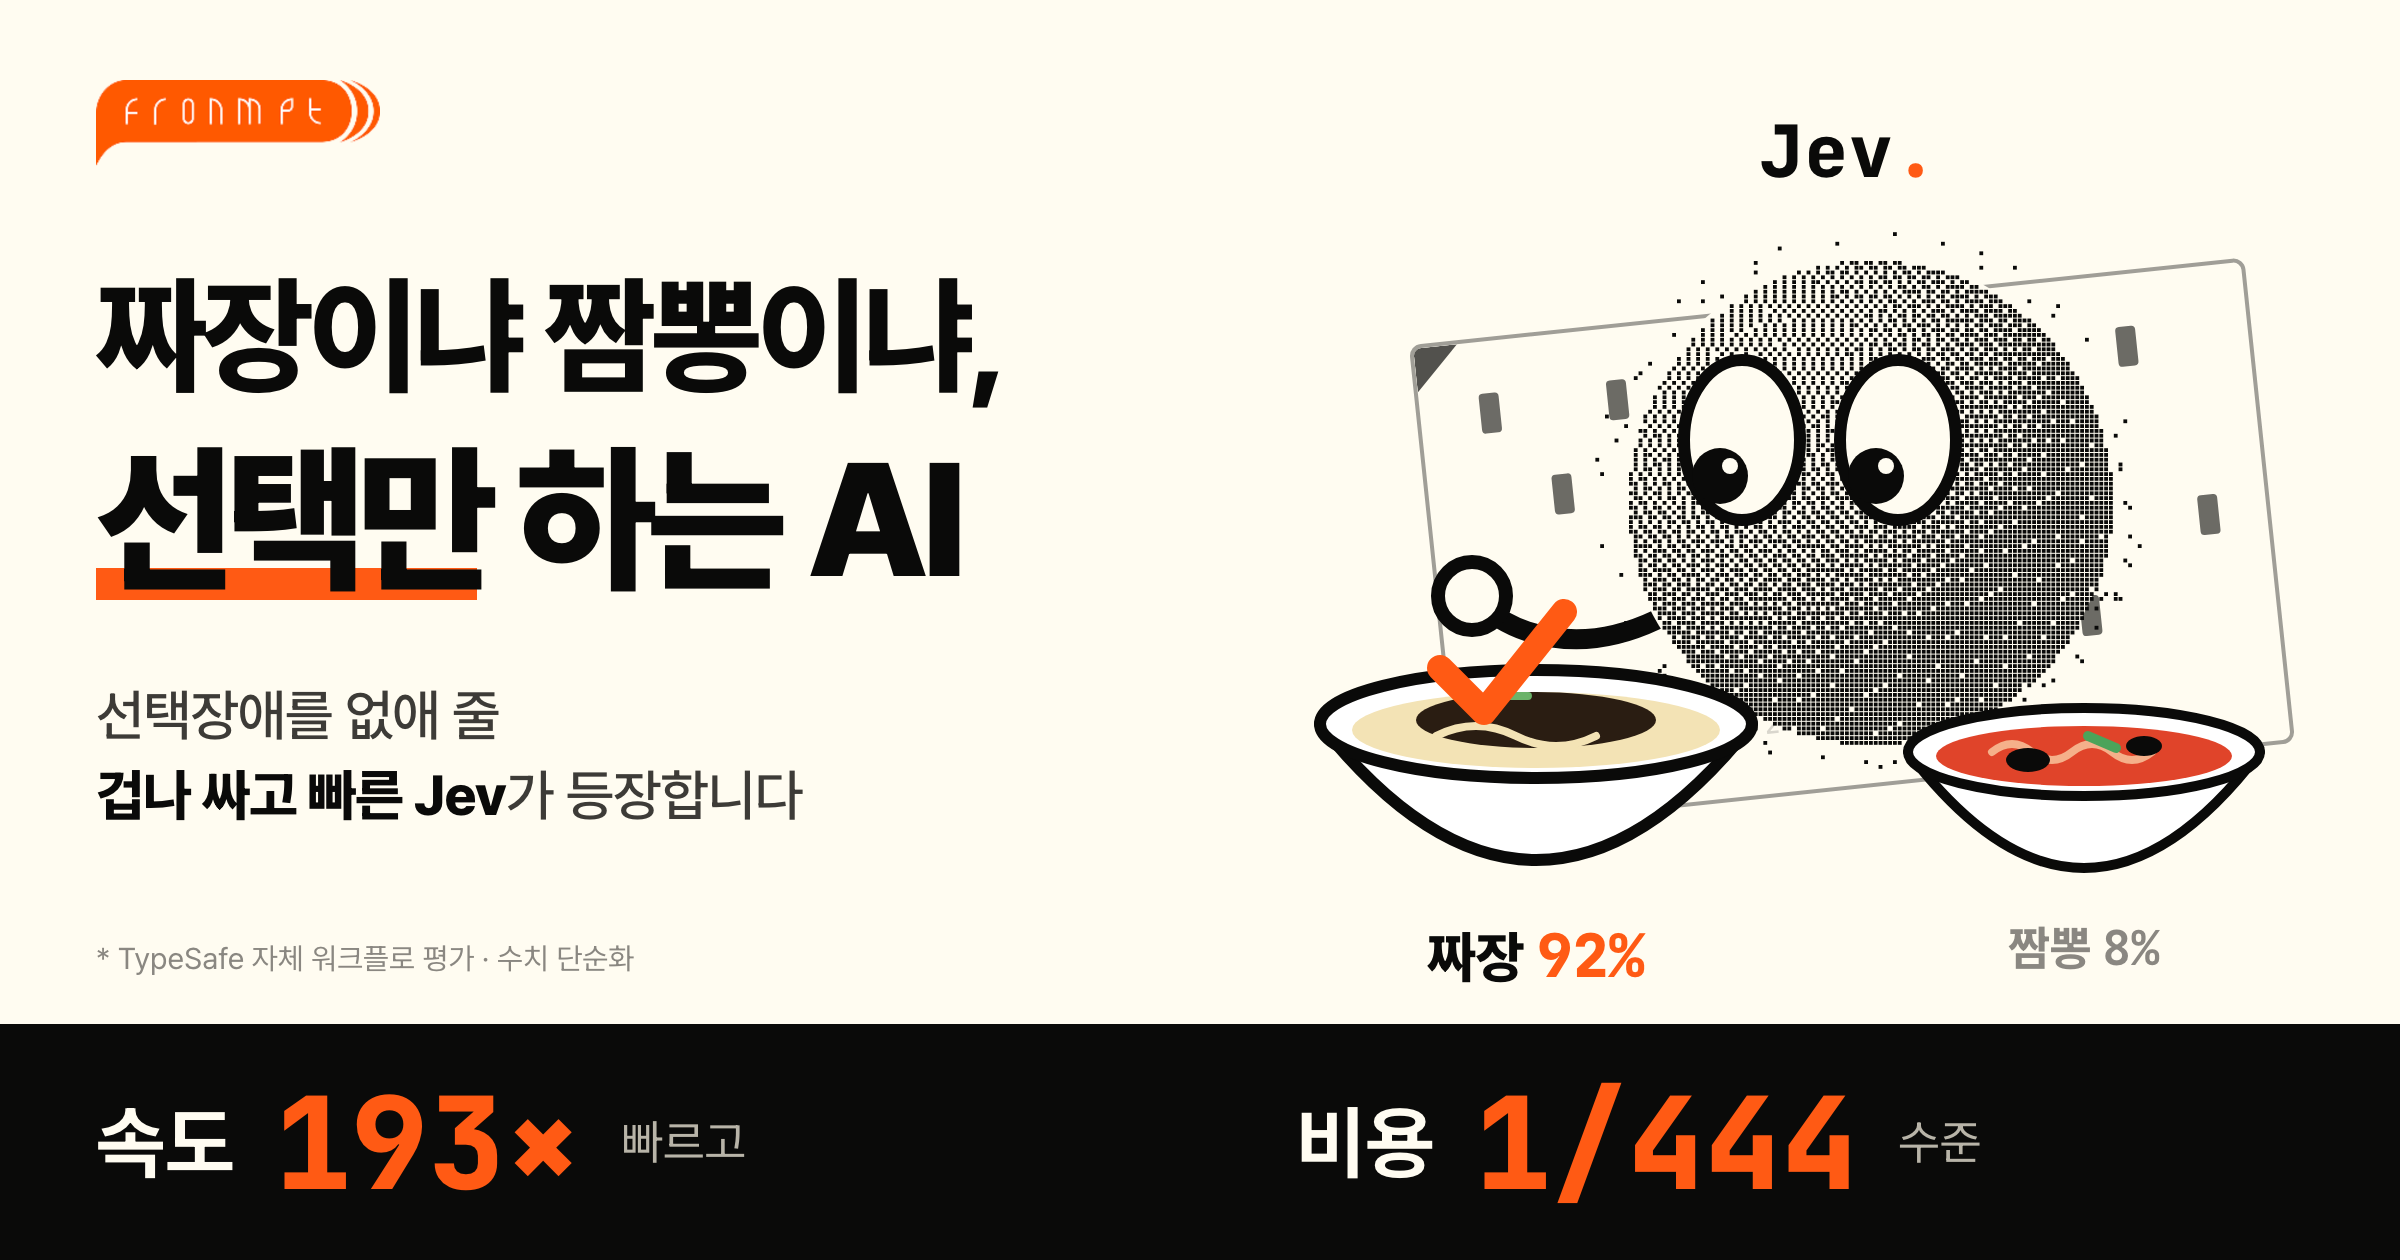
짜장이냐 짬뽕이냐 고르기만 하는 AI 제브(Jev). 싸고 빠르다길래 직접 써 봤습니다.
Eungje Park
October 21, 2026
점심 메뉴를 물었는데 A4 한 장짜리 답장을 받은 적 있으세요? 날씨와 어제 먹은 메뉴까지 한참 따지다가 마지막 줄에야 "짜장면"이라고 적어 보내는 동료요.
AI에게 분류를 시켜도 비슷합니다. "이 문의, 환불 요청이야?"라고 물으면 '예' 한마디면 되는데, ChatGPT나 Claude는 그 한마디를 내려고 긴 답장을 쓰듯 한 글자씩 만들어 냅니다.
TypeSafe AI가 내놓은 제브(Jev)는 정반대입니다. 글은 한 글자도 쓰지 않고 "짜장 0.92, 짬뽕 0.08"처럼 확률만 돌려줘요. TypeSafe는 제브가 기존 AI보다 193.6배 빠르고 444.6배 싸다고 발표했습니다.
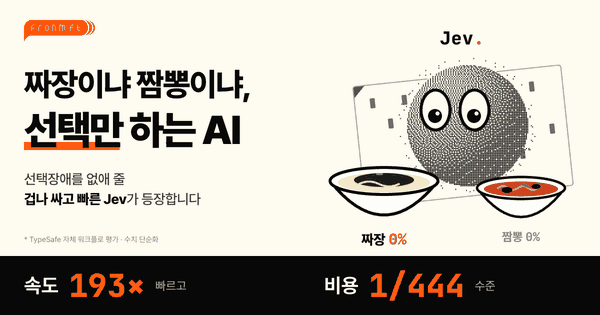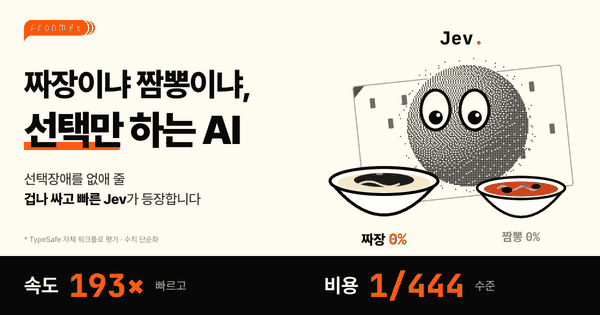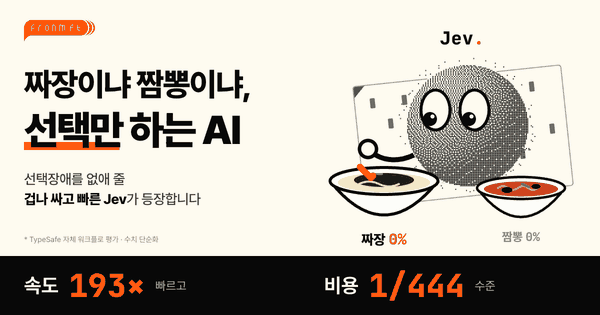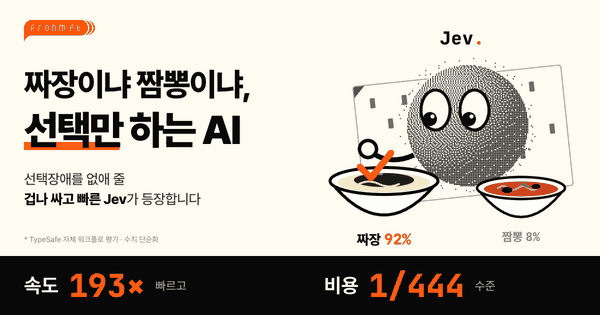
확률은 설명용 예시
숫자가 궁금해서 저도 제브로 도구 세 개를 만들어 봤습니다. 두 개는 효과를 봤고, 하나는 오히려 1.8초 느려졌어요. 어디에 써야 이득인지 차례로 정리했습니다.
AI는 한 조각씩 쓰느라 느립니다

TypeSafe · 기존 AI와 제브가 답을 내는 방식
ChatGPT나 Claude는 답을 토큰이라는 작은 조각으로 이어 붙여 씁니다. 조각 하나를 쓸 때마다 모델 전체를 한 번씩 돌려야 해요. 100조각짜리 답이면 모델을 100번 넘게 돌리는 거죠.
AI 회사들이 출력 요금을 입력보다 다섯 배쯤 비싸게 받는 것도 이 때문입니다. 답이 길어질수록 돈이 더 나가요.
제브는 이 과정을 아예 건너뜁니다. 입력을 한 번 읽고, 미리 정해 둔 보기마다 확률을 붙여서 돌려줘요.
질문: "이 문의는 결제·주문·반품·계정 중 어디로 보낼까?"
제브: 반품 0.95, 계정 0.03, 결제 0.01, 주문 0.01
숫자로 보면 이렇습니다
입력 100만 토큰에 0.042달러. 글을 안 쓰니 출력 요금은 따로 없어요.
판단 한 번에 0.07~0.5초.
답은 세 가지 형태로만 나와요. 보기 고르기, 점수 매기기, 예/아니오 확률이에요.
같은 질문을 천 번 던지는 일에 제격이에요

TypeSafe · 작업별 정확도와 비용
제브는 같은 판단을 수없이 반복하는 일에 강합니다. TypeSafe가 공개한 평가를 보면 정확도는 중간급 AI와 비슷한데, 비용은 10분의 1에서 100분의 1 수준이었어요. 이런 일에 잘 맞습니다.
고객 문의를 결제·배송·환불로 나누기
댓글과 문자에서 스팸 거르기
신청서에서 조건에 맞는 사람 추리기
먼저 써 본 개발자들도 이런 일을 맡겼습니다.
논문 선별. 1,018편을 한 편씩 판정하는 데 8센트가 들었어요.
항공권 검색. 취리히발 런던행 표를 7.1초 만에 찾았어요.
드론 제어. 1초에 두세 번씩 날아갈 방향을 정해요.
Vercel은 사내 분류 작업을 제브로 바꾸고 속도가 6배 빨라졌다고 해요.
물론 못하는 일도 있습니다. 고객 응대에서는 가장 정확한 AI보다 2.3%p 덜 맞혔고, 인보이스 처리에서는 17.3%p나 뒤처졌어요.
이런 일은 맡기지 마세요
글쓰기. 애초에 글을 쓰지 않는 모델입니다.
숫자 계산과 날짜 비교. 이건 코드로 하라고 TypeSafe 문서에도 적혀 있어요.
보기가 수십 개가 넘는 분류. 아래에서 따로 다룰게요.
채용 심사처럼 근거를 대야 하는 판정. 제브는 어느 대목을 보고 그렇게 판단했는지 알려 주지 않습니다.
한국어 중심 작업. 한국어도 처리는 하지만 영어만큼은 아니라고 TypeSafe가 직접 밝혔어요. 쓰기 전에 직접 테스트해 보세요.
보기 77개짜리 분류에선 GPT에게 밀립니다
개발자 Aman Kumar가 공개 데이터 네 종으로 1만 6천 번을 호출해서 정확도를 쟀습니다.
스팸 거르기(보기 2개): 제브 98.7%, GPT-5.4 mini 97.7%
뉴스 주제 분류(보기 4개): 제브 91.3%, GPT-5.4 mini 88.3%
은행 문의 분류(보기 77개): 제브 76.0%, GPT-5.4 mini 78.7%, GPT-5.6 Luna 81.7%
짜장이냐 짬뽕이냐는 잘 고르는데, 메뉴판이 77줄로 늘어나면 헷갈려 합니다. 질문 문구만 바꿔도 정확도가 5%p씩 오르내렸다고 합니다.
묻는 방식에 따라서도 답이 달라집니다. 같은 내용을 예/아니오로 물었더니 0.22가 나왔는데, 보기 고르기로 물었더니 '아니오'에 0.99를 줬어요.
답이 흔들릴 때도 있습니다. "이 손해가 보장 대상인가"를 같은 조건으로 15번 물었더니 0.43에서 0.53 사이를 오갔습니다. 0.5 하나로 자르면 물을 때마다 답이 예와 아니오로 바뀌는 거예요.
그래서 저는 기준선을 두 개 둡니다.

확률로 나누는 세 구간
0.3 미만: '아니오'로 자동 처리
0.7 초과: '예'로 자동 처리
그 사이: 사람이 검토
확률이 답마다 붙어 나오니까 이렇게 나누는 건 코드 몇 줄이면 됩니다. 다만 그 확률이 실제로 얼마나 맞는지 보여 주는 보정 데이터는 TypeSafe가 아직 공개하지 않았어요. 처음에는 사람이 보는 구간을 넉넉하게 잡아 두세요.
193배를 보려면 메뉴를 한꺼번에 물어야 해요

TrueStandard 측정 · 판단 1회와 6회 묶음
독립 측정 기관 TrueStandard가 같은 작업을 세 번씩 돌려서 중앙값을 뽑았습니다.
판단 1번: 제브가 다른 AI보다 1.7~5.4배 빨랐어요. 제브가 0.48초, 다른 AI는 0.8~2.6초였습니다.
판단 6개를 한 번에 묶으면: 제브가 100.7배 빨랐어요. 다른 AI를 여섯 번 차례로 부르면 74초가 걸리는데, 제브는 한 번에 0.7초면 끝납니다.
TrueStandard의 결론은 이랬어요.
몇 배 빠르냐는 모델보다 무엇과 비교하느냐에 달렸다.
TypeSafe가 말한 193배도 판단을 잔뜩 묶어 보낸 작업에서 나온 숫자입니다. 판단이 한두 번뿐인 일이라면 몇 배 정도로 기대치를 낮추는 게 맞아요.
직접 만든 도구 세 개, 두 개만 이득을 봤어요

제 실측 · 뉴스 에이전트에 제브를 넣었을 때
카피 톤 검사기. 블로그 카피를 쓸 때 지키는 톤 규칙이 있어요. 원래는 코드(정규식)로 검사했는데, 정규식은 글자 모양만 보지 뜻은 못 읽거든요. 그래서 "사람이 아닌 것이 주어로 나오는지" 같은 규칙 세 개는 제브에게 맡겼습니다. 질문 1,411개를 71번에 나눠 보냈더니 모델 호출이 20분의 1로 줄었어요.
큐레이터 제브. 궁금한 걸 한 줄로 적으면 제브가 검색 결과 25곳을 하나씩 읽고 판정합니다. 자료마다 "관련 자료", "확인 필요" 도장을 찍고, 근거가 된 원문 문장도 그대로 보여 줘요. 25곳 중에서 열어 볼 곳 13곳, 확인이 필요한 곳 3곳으로 추려 줬습니다.
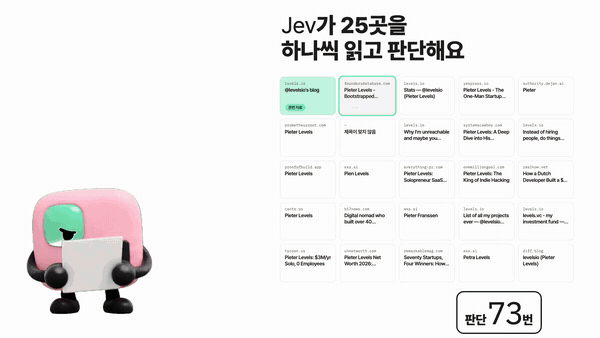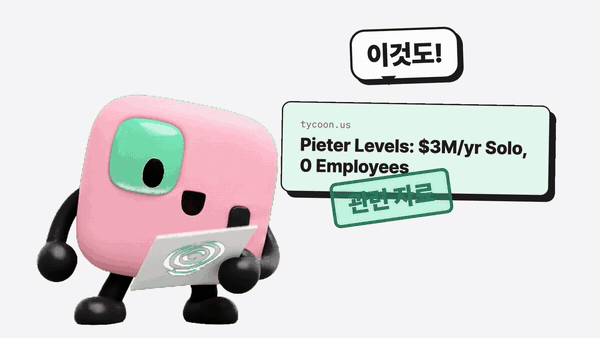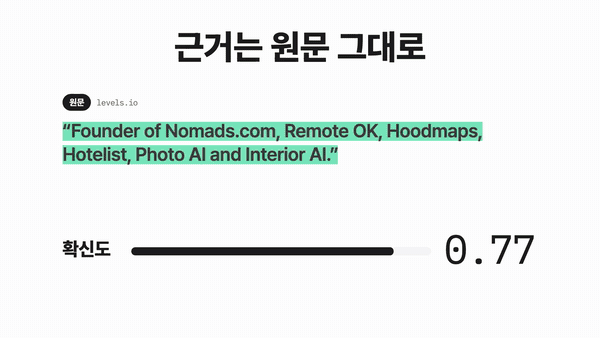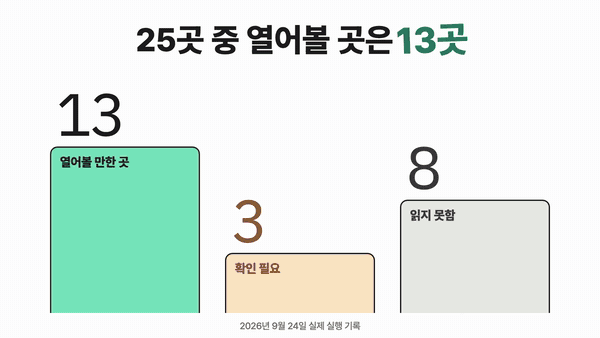
제가 만든 큐레이터 제브
뉴스 고르는 에이전트. 브라우저로 뉴스 후보 8개를 읽고 그중 2개를 고르는 에이전트예요. 제브를 넣었더니 계획 단계는 한 번 줄었는데, 그 대신 제브를 두 번 새로 불러야 했어요. 고른 기사는 똑같았고 시간만 1.8초 더 걸렸습니다. 계획 한 번을 아끼려다 호출을 두 번 늘린 셈이었어요.
작업 | 판단 횟수 | 결과 |
|---|---|---|
블로그 카피 톤 검사 | 1,411번, 71번에 묶어 보냄 | 모델 호출 20분의 1 |
큐레이터 제브 | 검색 결과 25곳을 한 곳씩 | 열어 볼 곳 13곳으로 추림 |
뉴스 고르는 에이전트 | 2번, 묶을 수 없음 | 1.8초 손해 |
같은 모델인데 두 곳에서는 효과를 봤고, 한 곳에서는 손해를 봤습니다. 차이는 판단 횟수에서 났어요. 판단을 몇 번이나 하는지, 그걸 한 번에 묶어 보낼 수 있는지부터 따져 보세요.
쓰기 전에 세 가지만 물어보세요
1. 같은 판단을 몇 번 반복하나. 한 작업에 두세 번이면 이득이 거의 없어요. 적어도 수십 번은 돼야 써 볼 만합니다.
2. 그 판단을 한 번에 묶어 보낼 수 있나. 하나씩 따로 보내야 한다면 판단이 많아도 이득이 크지 않아요.
3. 보기가 몇 개인가. 보기가 적을수록 잘 맞혀요. 수십 개가 넘어가면 지금 쓰는 AI와 정확도부터 비교해 보세요.
세 가지에 다 해당하면 제브를 써 볼 만합니다. 하나라도 걸리면 지금 쓰는 AI로도 충분해요.
원리와 표, 출처는 블로그에 두 편으로 나눠 정리해 뒀습니다.
제브에게 못 맡기는 두 가지
제브라는 이름은 경제학자 제번스에서 따왔습니다. 증기기관 효율이 좋아졌더니 석탄을 덜 쓰기는커녕 더 많이 쓰게 됐다는 '제번스 역설'의 그 제번스입니다.
저도 그렇습니다. 판단 한 번에 돈을 쓰기 아까워서 예전에는 코드 규칙으로 버텼는데, 지금은 톤 규칙 세 개를 모두 제브에게 묻고 있어요.
그래도 무엇을 쓸지, 누구에게 팔지는 아직 제가 정합니다.

판단이 싸질수록 어디까지 AI에게 맡길지를 더 자주 고민하게 됩니다.
Fronmpt Academy에서는 이 고민을 실제 작업으로 풀어 봅니다. AI 자동화를 그대로 열어 두고, 시즌마다 하나씩 같이 만들어요.
오늘도 읽어 주셔서 고맙습니다.
AI로 만들고 운영하는 이야기, Fronmpt
엉클잡스 올림
새 글 소식과 작업 이야기는 여기서 더 자주 나눠요.
📌 오픈채팅방: 엉클잡스 오픈채팅 들어가기
✅ 스레드: @unclejobs.ai